先生のための統計の超基礎 ― 自分のクラスの点数で、平均・t検定・効果量・相関を使ってみる
統計は「論文を読むための知識」であると同時に、「自分のクラスのデータを正しく見るための道具」です。グラフを描く→平均とばらつき→t検定と効果量→相関、の順に、小テストの点数を例にかみ砕きます。
エビデンスの強さ:効果を測る対象ではなく、統計の考え方と手順を整理したページ。手順の推奨は統計手法の方法論論文にもとづく。
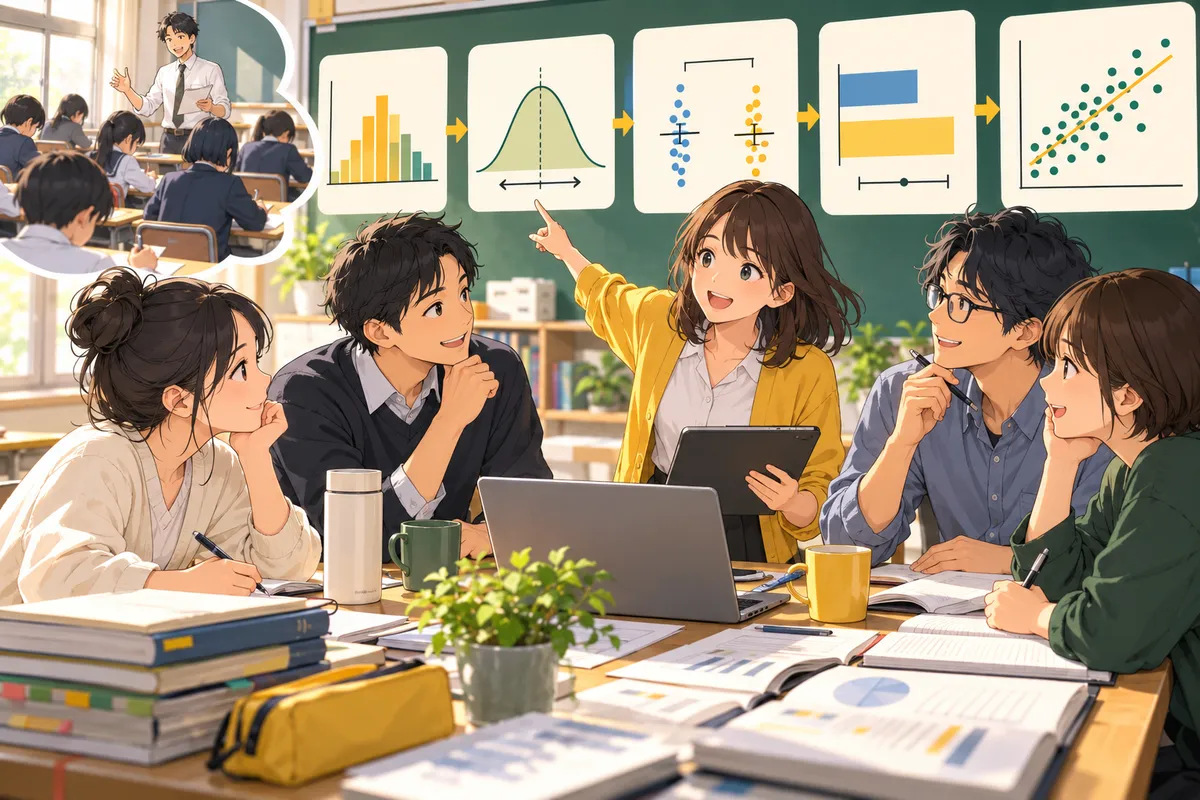
- まずグラフ。 平均の棒グラフだけでは、違う分布が同じに見えます。点数は1人1点ずつの「点の図」や箱ひげ図で見ましょう。
- 2クラスの比較はWelch の t 検定が基本。そして「有意かどうか」より効果量(差の大きさ)を必ず添えます。
- 「苦手な生徒が伸びた!」の前に平均への回帰を疑う。低かった人は、何もしなくても次は少し上がりやすいのです。
統計ってなに? ― 「まとめる」と「確かめる」
ひとことで言うと、統計は、クラスの点数などの数字を「ひと目でわかる形にまとめ」、見えた差が「たまたまのぶれではないか確かめる」ための道具です。
統計には、大きく2つの仕事があります。
- まとめる(記述統計):40人分の点数を、平均・ばらつき・グラフで「ひと目でわかる形」にする。
- 確かめる(推測統計):見えた差が、偶然のぶれでも出そうな差なのか、そうでないのかを判断する(t検定など)。
論文の読み方では、論文に出てくる数字を「読む」側から説明しました。このページは反対に、自分のクラスのデータを「扱う」側の話です。
統計は健康診断に似ています。身長・体重・血圧を測って一覧にするのが「まとめる」。去年より体重が2kg増えたのが、日による変動の範囲なのか、本当に増えたのかを判断するのが「確かめる」です。そして、お医者さんが数字だけでなく本人の顔色や様子も見るように、統計の数字も、もとのデータ(生徒1人1人の点)を見ながら読むのが基本です。
まぎらわしい2つのちがい
| まぎらわしい2つ | ちがい |
|---|---|
| 平均 と 中央値 | 平均は全員の点を足して人数で割った「重心」で、極端な点(欠席の0点など)に引っぱられやすい。中央値は真ん中の生徒の点で、引っぱられにくい |
| t検定(p 値) と 効果量 | t検定は「その差は、偶然のぶれでも出そう?」を見る。効果量は「どれくらい違う?」を表す。t検定の答えは差の大きさを教えてくれない 1 |
| 対応のない t 検定 と 対応のある t 検定 | 別々の生徒どうし(1組と2組)を比べるなら「対応のない」、同じ生徒の前後(4月と7月)を比べるなら「対応のある」 |
このページでわかること3つ
- 計算の前にグラフを描く理由と、平均・中央値・標準偏差の読み方
- t検定・差の大きさ(Cohen の d)・相関を自分のクラスのデータで使うときの手順と、人数が少ないときの注意
- アンケートと自作テストの注意点、そして次の小テストの点数で統計を1回使ってみる手順
ステップ1:計算の前に、グラフを描く
いちばん大事で、いちばん飛ばされがちなのがこのステップです。
生理学の主要誌の論文703本を調べた研究では、ほとんどの論文が連続的なデータを平均の棒グラフや折れ線グラフで示しており、1人1人のデータが見える散布図・箱ひげ図・ヒストグラムはまれでした。著者たちは、まったく違う分布でも同じ棒グラフになりうるので、特に人数が少ない研究では個々のデータを見せる図にすべきだと提案しています 2。第二言語研究でも、数字の要約と同じくらい図の要約が大切で、棒グラフより箱ひげ図を使うよう勧める論文があります 3。
教室で言えば、2クラスの平均点がどちらも65点でも、
- Aクラス:ほぼ全員が55〜75点に集まっている
- Bクラス:90点台の生徒と30点台の生徒に分かれている
なら、次の授業でやるべきことはまったく違います。平均だけを見ていると、Bクラスの「二極化」に気づけません。
ステップ2:平均・中央値・標準偏差
| 数字 | 意味 | 教室のことばで |
|---|---|---|
| 平均(M) | 全員の点を足して人数で割る | 「クラスの重心」 |
| 中央値 | 点数順に並べた真ん中の人の点 | 「真ん中の生徒は何点?」 |
| 標準偏差(SD) | 平均からのばらつきの大きさ | 「点数が平均からどのくらい離れて散らばっているか」 |
ここで、10人の小テスト(100点満点)を例にします。62・64・65・66・68・70・71・72・74・78点なら、平均も中央値も69点、標準偏差は約4.9点です。ところが、欠席して0点がついた1人がまじる(62点が0点になる)と、平均は62.8点まで下がり、標準偏差は約22.5点にふくらみます。中央値は69点のままです。平均は極端な値に引っぱられやすく、中央値は引っぱられにくいのです(この数値は手計算の例です)。
だから、平均を出す前に「0点や白紙の答案をどう扱うか」を決めておきます。欠席の0点を「英語力が0」として平均に入れるのは、たいてい不適切です。
ステップ3:2つのグループを比べる ― t検定と効果量
t検定は「偶然のぶれでも出そうか」を見る
t検定は、2つの平均の差が、偶然のぶれ(たまたまの当たり外れ)でも出そうな大きさかどうかを調べる方法です。使い分けは次のとおりです。
| 場面 | 使うもの | 例 |
|---|---|---|
| 別々の生徒どうしを比べる | 対応のない t 検定 | 1組と2組の単語テスト |
| 同じ生徒の前後を比べる | 対応のある t 検定 | 同じクラスの4月と7月 |
対応のない t 検定には、昔ながらの Student の t 検定と、2つのグループのばらつき(分散)が等しいと仮定しない Welch の t 検定があります。2つのばらつきが等しいことはめったにないうえ、等しいかどうかを事前の検定で判断して使い分けるやり方もうまく働かないことが多いので、Welch の t 検定を標準にするのがよいという論文があります。Welch 版は、ばらつきが違うときに誤った「有意」を出しにくく、ばらつきが等しいときにも失うものはわずかだと示されています 4。無料ソフトの多くは Welch 版を選べます。
ただし、1組と2組で指導法を分けて比べる場合、差には指導法だけでなく、クラスの雰囲気や時間帯などの違いも混ざります。各指導法1クラスずつなら、t 検定の結果も「この2クラスではこうだった」という記述にとどめ、「指導法の効果」とは言い切らないようにしましょう。
効果量は「どれくらい違うか」を表す
t検定の答え(p 値)は、差の大きさを教えてくれません。そこで効果量を添えます。2クラスの比較でよく使う Cohen の d は、平均の差を標準偏差で割ったものです(用語集:Cohen の d) 1。
たとえば、1組の平均が68点、2組が62点で、どちらも標準偏差が12点なら、d = (68 − 62) ÷ 12 = 0.5 です。心理学者の Jacob Cohen 氏の慣例では 0.2 が小、0.5 が中、0.8 が大とされます 5。ただし第二言語研究では、この目安は効果を小さく見積もりがちだとして、分野に合わせた目安も提案されています 6(くわしくは論文の読み方)。
効果量は、論文に載せるためだけのものではありません。次の研究で何人必要かを見積もるためにも、ほかの研究と比べるためにも使えます。t検定や分散分析の効果量の計算と報告のしかたは、実用的な入門論文にまとまっています 1。日本の英語教育研究に向けて、効果量の基本的な考え方と報告の注意点を日本語でまとめた論文もあります 7。
何人いれば差を見つけられる?
人数が少ないと、本当は差があっても「有意差なし」になりやすくなります。これを検出力(差を見つける力)の問題といいます。Cohen 氏は、検出力 .80 を得るのに必要な人数の表を示しました 5。同じ考え方で計算すると(両側5%、Welch ではなくふつうの t 検定の近似)、中くらいの差 d = 0.5 を80%の確率で見つけるには1グループ約64人が必要で、40人学級2クラス(各40人)だと検出力は約6割にとどまります(この数値は計算による)。第二言語の量的研究606本の点検でも、検出力の低さが弱点の1つに挙げられています 8。
「有意差なし」=「効果なし」ではない。教室で調べるときは、これを何度でも思い出してください。
ステップ4:相関 ― 2つのものが「一緒に動く」度合い
相関係数 r は、−1〜+1 の数で、2つの変数がどれくらい一緒に動くかを表します(用語集:相関係数)。「音読の回数」と「読む速さ」のように、同じ生徒について2つの数字があるときに使います。
計算の前に、ここでも散布図を描きます。1人の極端な生徒が r を大きく動かしていることがよくあるからです。
相関は「1クラス分」では安定しない
シミュレーションで「相関係数が真の値の近くで落ち着くには何人必要か」を調べた研究では、典型的な場面では250人ほどが必要だと結論しています。著者たち自身のデータでも、20人の時点で r = .69 だった相関が、274人まで集めると r = .26 になっていました 9。
40人のクラスで「r = .5 だった!」と思っても、その数字は来年のクラスでは大きく変わるかもしれません。少人数の相関は、「そういう傾向が見えた」くらいの控えめな言い方にとどめるのが安全です 9。
ステップ5:アンケートと自作テストの注意点
4段階・5段階のアンケートに平均やt検定を使ってよい?
「とてもそう思う〜まったく思わない」のリッカート尺度は順序の尺度なので、平均やt検定は使えない、という批判がよくあります。これに対して、1930年代からの多くの研究が、パラメトリックな方法(t検定・分散分析・相関など)は、データがこうした前提(目盛りの間隔が等しい数値であること)から多少ずれていても、結果が大きくは狂わないことを示しており、心配しすぎる必要はないと論じた論文があります 10。ただし、平均だけでなく各選択肢の人数の分布も必ず見ましょう。「平均3.0」が「全員が3」なのか「1と5に真っ二つ」なのかで、意味はまったく違います。
信頼性係数(クロンバックのα)
同じ力を測るつもりの項目(たとえば「英語への不安」5項目)に、生徒がどのくらい一貫して答えているか(内的一貫性)の目安がα係数です(用語集:信頼性)。ただし、αが高いだけでは、全項目が同じ1つの力を測っているとまでは言えません。解説論文は、次の4点を指摘しています 11。
- 許容できる値として報告されているのは0.70〜0.95と、さまざまである。
- 0.90を超えたら、似た項目が重なっていないかを疑う。
- αは、項目数が少ないと低く出る。
- αはテストそのものではなく、その時の受験者集団の点数の性質なので、毎回計算し直す。
明日の授業でこうする
- データを表にする:1行1人、列に「事前テスト」「事後テスト」「クラス」。欠席・未提出は空欄にし、0点を入れない。
- グラフを描く:クラスごとに点数を点で並べた図か箱ひげ図。二極化や極端な点がないかを見る 2。
- 平均・中央値・標準偏差を出す:平均と中央値が大きくずれていたら、極端な点の影響を疑う。
- 比べる:2クラスなら Welch の t 検定と d、同じクラスの前後なら対応のある t 検定と、前後の効果量(下の大学院レベル参照)。
- ことばで書く:「1組は2組より平均で6点高く、d = 0.5 の中程度の差だった。ただし事前の差は確かめていない」のように、数字・大きさ・限界をセットで書きます 1。
- 中学校:単語テストの平均が上がったと喜んだが、点の図を描くと、上位の生徒がさらに上がっただけで、下位の生徒は変わっていなかった。翌週から下位の生徒向けに「出題語を事前に3回声に出す」時間を入れた。
- 高校:アンケートの「授業はわかりやすい」の平均が3.4(5段階)と出たが、分布を見ると5と2に分かれていた。2をつけた生徒の自由記述を読み、説明が速すぎる場面が特定できた。
- 小学校:「英語が好き」と「家で英語の歌を聞く回数」の相関を出したところ高かったが、30人の結果なので「関係がありそう」とだけ学年だよりに書いた。
- 補習クラスの「伸び」をそのまま喜ぶ:事前テストで低かった生徒を選ぶと、何もしなくても次は平均に近づきます。極端な値の後には平均に近い値が続きやすいという平均への回帰は、測定の誤差が大きいほど、そして最初の値で選んだ一部の人だけを追うときほど目立ちます 12。比べるグループを置くか、1回のテストの点だけで対象の生徒を選ばないようにしましょう。
- 「有意差なし」で結論を出す:人数が少なければ、差があっても有意にならないことがよくあります 5。
- 平均の棒グラフだけを載せる:分布が見えません 2。
- α係数を他人の論文から借りる:αは毎回の受験者集団で計算し直します 11。
- t検定をくり返す:3クラス以上を2つずつ何度も比べると、偶然の「有意」が出やすくなります。分散分析など、まとめて比べる方法を使います。
❓ よくある質問
Q. 統計の分析は何から始めればいいですか?
計算の前にグラフを描きます。平均の棒グラフだけでは、まったく違う分布でも同じに見えてしまうので、1人1点ずつの点の図や箱ひげ図で見ることがすすめられています 23。平均が同じ65点でも、点数が集まっているクラスと二極化したクラスでは、次の授業でやるべきことが違います。
Q. 2クラスの比較にはどのt検定を使えばいいですか?
2つのグループのばらつきが等しいと仮定しない Welch の t 検定を標準にするのがよい、という論文があります 4。そして「有意かどうか」より、差の大きさを表す効果量(Cohen の d など)を必ず添えます 1。
Q. 40人のクラス2つで差を見つけられますか?
難しいことがあります。中くらいの差 d = 0.5 を80%の確率で見つけるには1グループ約64人が必要で、40人学級2クラスでは検出力は約6割にとどまる計算です 5。「有意差なし」は「効果なし」ではありません。
Q. 苦手な生徒が補習で伸びたのは指導の効果ですか?
まず平均への回帰を疑います。事前テストで低かった生徒を選ぶと、何もしなくても次のテストでは平均に近づきやすく、これは測定の誤差が大きいほど、最初の値で選んだ一部の人だけを追うときほど目立ちます 12。比べるグループを置くか、1回のテストの点だけで対象の生徒を選ばないようにしましょう。
Q. 1クラス分の相関係数は信用できますか?
控えめに読みます。相関係数が真の値の近くで落ち着くには、典型的な場面で250人ほどが必要だというシミュレーション研究があり、20人の時点で r = .69 だった相関が274人で r = .26 になった例も報告されています 9。少人数では「そういう傾向が見えた」くらいの言い方にとどめます。
🎓 もう一歩深く(大学院レベル)
🎓院生モード事前・事後の効果量は、1つではない
同じ生徒の前後を比べる研究(群内デザイン)の効果量は、計算のしかたが1つではありません。事前と事後の相関(同じ生徒がどれくらい同じ順位を保つか)を組み込むかどうかで値が変わり、群間デザインの d とそのまま比べてよいとは限りません。t検定・分散分析の効果量の入門論文は、群間と群内の違いを詳しく比べたうえで、研究の問いに合わせて選ぶよう勧めています 1。
事前・事後テストと対照群の両方がある「事前事後統制群デザイン」については、3つの効果量の推定方法を偏り・精度・分散の違いへの強さで比べた研究があり、実験群の前後の変化から対照群の前後の変化を引き、事前テストの標準偏差(両群をあわせたもの)で割る方法が最もよいと結論しています 13。群内の効果量は、「指導なしでも起きる伸び」や事前・事後の相関の影響を含みやすいので、群間の d と同じ物差しで「大きい・小さい」を判断しないよう注意が必要です(群間・群内で目安を分けて読む考え方は論文の読み方で紹介しています)。修士論文では、どの式で計算したかを必ず明記しましょう。
🎓院生モード頑健な統計と「グラフ第一」の考え方
第二言語研究に応用統計の新しい流れを紹介した論文は、①図による要約の改善(棒グラフより箱ひげ図、散布図に Loess 曲線を加える)と、②頑健な統計(トリム平均やブートストラップ)の利用を勧めました。頑健な方法は、データが正規分布に近いときはふつうの方法とほぼ同じ精度で、外れ値やゆがみがあるときはしばしばより正確だと述べています 3。
一方、リッカート尺度へのパラメトリック検定については「頑健なので使ってよい」という立場の論文もあり 10、「正規性の前提を満たさなければ使えない」という硬い規則よりも、分布を見て、外れ値の影響を確かめ、必要なら頑健な方法で同じ結論になるかを確認するという姿勢が現在の主流と言えるでしょう。2群比較で Welch の t 検定を標準にする提案も、同じ考え方の延長にあります 4。
🎓院生モードどのソフトで、何で学ぶか
統計ソフトは無料のものが充実しています。表計算ソフトのような画面で使える jamovi 14 と JASP 15、研究者が広く使う R 16 はどれも無料です。日本の言語研究者が公開しているウェブ上の分析ツール集もあり、t検定・効果量・信頼性係数・ANCOVA などをブラウザで計算できます 17。
学ぶ順番としては、日本語の『外国語教育研究ハンドブック』で研究デザインと手法の全体像をつかみ 18、第二言語研究の例で SPSS と R を実際に動かす、応用言語学者の Jenifer Larson-Hall 氏の教科書 19 に進むのが近道です。研究全体の方法の選び方は英語教育研究の方法を参照してください。
🎁 玉手箱で使えるツール
原田英語の「英語の先生の玉手箱」の無料ツール。登録なしで授業にそのまま使えます。
🔗 あわせて読みたい
 🎓 TESOL
論文の読み方 ― 効果量・信頼区間・p値・メタ分析を英語の先生向けにかみ砕く
「有意差あり」は「よく効く」という意味ではありません。効果量 d、信頼区間、メタ分析、出版バイアス。英語教育の論文を読むのに必要な道具を、教室のたとえで一つずつ説明します。
📐理論中学校高校大学・院
 🎓 TESOL
英語教育研究の方法 ― 実験・調査・質的研究・混合研究を「問い」から選ぶ
「効果があるか」を知りたいのか、「なぜそうなるのか」を知りたいのか。研究の方法は、流行りや好みではなく、問いの形で決まります。実験・アンケート・インタビュー・混合研究の使いどころを、教室の例でかみ砕きます。
📐理論中学校高校大学・院
 🎓 TESOL
自分の授業で研究する ― アクションリサーチ入門(まず「探る」から始める)
研究は大学の先生だけのものではありません。自分の教室の「気になること」を、記録して、試して、確かめる。アクションリサーチは、忙しい先生でも続けられる研究のかたちです。
☆☆☆研究はこれから小学校中学校高校
 🎓 TESOL
修士論文の書き方 ― 教室の悩みを「研究の問い」に変えて、2年で書き上げる手順
修士論文は「大発見」を書くものではありません。教室の悩みを、答えられる大きさの問いにしぼり、先行研究の地図の上に自分の小さな一歩を置く作業です。テーマ決めから先行研究・研究計画・章立て・研究倫理まで、英語教育の院生向けにかみ砕きます。
📐理論大学・院
 🛠️ 技能別
定期テストの作り方 ― 妥当性・信頼性・波及効果で「本文暗記テスト」を卒業する
教科書本文の穴埋めばかりの定期テストは、生徒に「本文を丸暗記すればいい」と教えてしまいます。テストの3つの物差しと、国研の作成手順、明日から使える問題チェックリストをまとめました。
★★☆エビデンスあり中学校高校
 🛠️ 技能別
英語の評価の基本 ― 形成的評価・観点別評価・CAN-DOを一本の線でつなぐ
評価は「成績をつける作業」だけではありません。授業の途中で生徒の今を見て、次の一手を決める。観点別評価もCAN-DOも、その一本の線の上にあります。
★★☆エビデンスあり小学校中学校高校
📑 出典(19件)
本文の上付き数字に対応。✔ は DOI / ISBN / 公式ページを書誌データベースと機械照合した印です。
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. doi:10.3389/fpsyg.2013.00863 ✔ DOI照合済t検定・分散分析の効果量の計算と報告のしかたを、対応あり・なしの違いも含めて解説した実用的な入門論文
- Weissgerber, T. L., Milic, N. M., Winham, S. J., & Garovic, V. D. (2015). Beyond bar and line graphs: Time for a new data presentation paradigm. PLOS Biology, 13(4), e1002128. doi:10.1371/journal.pbio.1002128 ✔ DOI照合済平均の棒グラフだけでは違う分布が同じに見えてしまうと示し、個々のデータを見せる図を勧めた論文
- Larson-Hall, J., & Herrington, R. (2010). Improving data analysis in second language acquisition by utilizing modern developments in applied statistics. Applied Linguistics, 31(3), 368-390. doi:10.1093/applin/amp038 ✔ DOI照合済第二言語研究に、グラフの改善(棒グラフより箱ひげ図)と頑健な統計を勧めた論文
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92-101. doi:10.5334/irsp.82 ✔ DOI照合済2群の比較では、分散が等しいと仮定しない Welch の t 検定を標準にすべきだと示した論文
- Cohen, J. (1992). A power primer. Psychological Bulletin, 112(1), 155-159. doi:10.1037/0033-2909.112.1.155 ✔ DOI照合済効果量の「小・中・大」の慣例値と、必要なサンプルサイズの表を示した有名な短い論文
- Plonsky, L., & Oswald, F. L. (2014). How big is "big"? Interpreting effect sizes in L2 research. Language Learning, 64(4), 878-912. doi:10.1111/lang.12079 ✔ DOI照合済第二言語研究の効果量の大小の目安を、346研究・91メタ分析から示した論文
- 水本篤・竹内理 (2008). 研究論文における効果量の報告のために:基本的概念と注意点. 英語教育研究(関西英語教育学会紀要), 31, 57-66. 公式ページ ✔ リンク確認済日本の英語教育研究向けに、効果量の基本的な考え方と注意点を日本語で解説した論文
- Plonsky, L. (2013). Study quality in SLA: An assessment of designs, analyses, and reporting practices in quantitative L2 research. Studies in Second Language Acquisition, 35(4), 655-687. doi:10.1017/S0272263113000399 ✔ DOI照合済第二言語の量的研究606本の研究デザイン・分析・報告の質を点検した研究
- Schönbrodt, F. D., & Perugini, M. (2013). At what sample size do correlations stabilize?. Journal of Research in Personality, 47(5), 609-612. doi:10.1016/j.jrp.2013.05.009 ✔ DOI照合済相関係数が安定するには、典型的な場合で250人ほど必要だとシミュレーションで示した論文
- Norman, G. (2010). Likert scales, levels of measurement and the "laws" of statistics. Advances in Health Sciences Education, 15(5), 625-632. doi:10.1007/s10459-010-9222-y ✔ DOI照合済リッカート尺度のデータに t 検定などを使ってよいかを論じ、パラメトリック検定の頑健さを示した論文
- Tavakol, M., & Dennick, R. (2011). Making sense of Cronbach's alpha. International Journal of Medical Education, 2, 53-55. doi:10.5116/ijme.4dfb.8dfd ✔ DOI照合済信頼性係数(クロンバックのα)の意味・前提・読み方の注意をまとめた短い解説
- Barnett, A. G., van der Pols, J. C., & Dobson, A. J. (2005). Regression to the mean: What it is and how to deal with it. International Journal of Epidemiology, 34(1), 215-220. doi:10.1093/ije/dyh299 ✔ DOI照合済平均への回帰(極端な値は次に平均に近づく)を、本当の変化と取り違えないための解説
- Morris, S. B. (2008). Estimating effect sizes from pretest-posttest-control group designs. Organizational Research Methods, 11(2), 364-386. doi:10.1177/1094428106291059 ✔ DOI照合済事前・事後テストと対照群がある研究の効果量の計算方法を比べた論文
- The jamovi project (2026). jamovi: Free and open statistical software 公式ページ ✔ リンク確認済表計算ソフトのような画面で t 検定・相関などができる無料・オープンソースの統計ソフト(公式サイト)
- JASP Team (2026). JASP - Free and User-Friendly Statistical Software 公式ページ ✔ リンク確認済アムステルダム大学が支える無料・オープンソースの統計ソフト(公式サイト)
- The R Foundation (2026). The R Project for Statistical Computing 公式ページ ✔ リンク確認済研究者が広く使う無料の統計解析環境 R の公式サイト
- 水本篤 (2026). langtest.jp: Web Tools for Language Research and Practice 公式ページ ✔ リンク確認済関西大学の水本篤氏による、言語研究向けのウェブ統計ツール集(t検定・効果量・信頼性など)
- 竹内理・水本篤 (2023). 外国語教育研究ハンドブック:研究手法のより良い理解のために (増補版). 松柏社 本の紹介ページ ✔ リンク確認済外国語教育研究の研究デザインと統計手法を日本語で解説したハンドブック
- Larson-Hall, J. (2015). A Guide to Doing Statistics in Second Language Research Using SPSS and R (2nd). Routledge doi:10.4324/9781315775661 ✔ DOI照合済第二言語研究の統計を SPSS と R で実際に手を動かして学べる教科書
最終更新 2026-10-18 ・ 原田英語 まちがいのご指摘はこちら