「発表された研究の大半はまちがい」は本当か? 有名論文の“計算”を読み解く
 2026.10.02
 English Corner(A2〜B2・4択クイズ)
 読む前に予想してみよう!
「統計的に有意(p<0.05)」なら、その研究結果が正しい確率は95%以上である
正しい確率は、調べる仮説の「当たりの割合」や研究の検出力、バイアスで大きく変わる。
 研究カード(どんな研究?)
- 対象
- 医学・心理学などの出版研究
- 規模
- 理論モデル/100研究の追試
- 研究の種類
- 確率モデルによる理論的分析+大規模追試
- 確かさ
- ★★★☆☆
2005年の有名論文は「発表された研究の多くは誤り」と計算をもとに論じた。でも答えは分野と前提しだい。「全部ウソ」とも「心配ない」とも言えない。
ひとことで言うと当たりの少ないくじを、雑に引くほど「当たり!」の中にハズレがまざる!
 論文スペック表研究デザイン・規模・結果・その後(玄人向け)
- 研究デザイン
- 確率モデルによる理論的分析(データ収集なし)
- 主な指標
- 陽性的中率(PPV)を、検出力・事前の見込みの比R・バイアスで表す
- 主な結論
- 研究規模が小さい、効果が小さい、分析の自由度が大きいなど、誤りやすさの6条件を提示
- 試算の例
- 十分な規模で事前の見込みが五分五分のランダム化比較試験なら正しい確率は約85%、当たりの比が1対10の探索的な疫学研究なら5回に1回ほど
- 反論・実測
- Goodman & Greenland (2007) がモデルの前提を批判。Jager & Leek (2014) は一流医学誌5誌の5,322個のp値から偽の発見を約14%と推定
- 関連する大規模追試
- 再現性プロジェクト(2015年):心理学100研究の追試で有意になったのは36%、効果の大きさは平均で元の半分ほど
もくじ
科学論文のタイトルで、これほど挑発的なものはそうありません。
"Why Most Published Research Findings Are False"――「発表された研究結果の大半はなぜ誤りなのか」。
2005年、医学研究者のヨアニディス(Ioannidis)さんがオープンアクセス誌『PLoS Medicine』に発表した論文です。科学への信頼をゆさぶる一本として、今も繰り返し引用されています。
ところがこの論文、実際に論文を集めて「ウソ」を数えたわけではありません。中身は、紙と鉛筆でもたどれる確率の計算です。では、その計算は何を前提にしていて、どこまで正しいのか。反論も含めて読み解いてみましょう。
01問い:「有意」の中に、ハズレはどれくらい混ざっている?
よくある誤解から始めましょう。「p<0.05 で有意なら、その結果が正しい確率は95%」。これはまちがいです。
5%というのは「効果がない仮説を調べたとき、うっかり有意になる確率」。知りたいのはその逆、「有意になった結果のうち、本当に効果があるものの割合」です。この二つは、病気の検査でいう「偽陽性率」と「陽性的中率」の関係と同じで、まったく別物です。
ヨアニディスさんの論文は、この陽性的中率を、検出力・事前確率・バイアスの三つで表す式を示し、さまざまな研究分野に当てはめたものでした。
02計算してみる:1,000個の仮説で考える
式を使わず、数で追いかけてみましょう(ここでの数字は説明用の例です)。
ある分野で1,000個の仮説が調べられ、そのうち本当に当たりなのは100個だけ(事前確率10%)だとします。
- ハズレの900個のうち、5%の45個がうっかり「有意」になる
- 当たりの100個のうち、検出力が80%なら80個が「有意」になる
有意になったのは合計125個。そのうち本物は80個なので、陽性的中率は約64%。すでに3分の1以上がハズレです。
では、研究が小さく、検出力が20%しかなかったら? 当たりから有意になるのは20個だけ。ハズレからの45個はそのままなので、有意65個のうち本物は20個、約31%。有意な結果の7割近くがハズレになります。
ここにバイアス(都合のいい分析・報告)が加われば、ハズレはさらに増えます。「大半は誤り」という結論は、当たりの少ない分野で、小さな研究を、柔軟な分析で行うと、こうなるという計算なのです。
036つの「誤りやすさ」の条件
論文は、こうした計算から、研究結果が誤りになりやすい条件を6つ挙げています。要約すると次のとおりです。
- 研究の規模が小さい
- 効果の大きさが小さい
- 調べる関係の数が多く、事前の絞り込みが弱い
- デザイン・定義・評価項目・分析方法の自由度が大きい
- 金銭的な利害や先入観が強い
- 多くのチームが競い合う「ホットな」分野である
6番目は少し意外です。競争が激しいほど、目立つ「有意」な結果を急いで発表しようとする圧力が強まり、偶然の当たりが先に世に出やすくなる、という理屈です(ただし、この6番目の条件には後で紹介する批判があります)。
論文では分野ごとの目安も示されています。十分な規模で、事前の見込みが五分五分の質の高いランダム化比較試験なら、結果が正しい確率はおよそ85%。一方、十分な規模の探索的な疫学研究でも、当たりの比率が1対10なら5回に1回ほど。3万個の遺伝子を調べて本物は30個、というような(当たりの比が1対1,000の)発見型の研究では、ひとつひとつの「発見」が正しい確率は0.1%前後にとどまる、と試算されました。
つまり「大半は誤り」は、すべての研究に一律に当てはまる宣告ではなく、条件の悪い研究ほどそうなるという主張なのです。
04検出力不足は「二重に」効く
2013年、バトン(Button)さんら(ヨアニディスさんも共著者)は、この理論を神経科学に当てはめました。
検出力が低いと「本物を見逃す」ことはよく知られています。でもバトンさんらが強調したのは、もう一つの害でした。検出力が低いと、有意になった結果が本物である確率そのものも下がる。上の1,000個の計算で、検出力80%と20%を比べたときに起きたことです。
さらに、小さな研究でたまたま有意になった結果は、効果の大きさを過大に見積もりがちになります。偶然大きく出たときだけ有意の線を越えるからです。この「勝者の呪い」によって、後から大きな研究で確かめると効果が縮んでしまう。バトンさんらは、神経科学の研究の平均的な検出力は非常に低いと結論づけています。
05現実のデータは理論どおりだったか
理論の予測を、現実で確かめるような大規模な試みも行われました。2015年の「再現性プロジェクト」では、心理学の100の研究を追試したところ、元の研究の97%が有意だったのに対し、追試で有意になったのは36%。効果の大きさも、平均で元の半分ほどに縮みました。
効果の縮みは、まさに「勝者の呪い」の予測どおりです。ただし注意も必要です。追試で有意にならなかったからといって、元の結果が「誤り」と決まるわけではありません。追試自体にも見逃しの可能性があります。再現率の数字は、そのまま「正しい研究の割合」ではないのです(追試の舞台裏や個別の事例は、パワーポーズの記事などでも紹介しています)。
ここまで読めば要点はつかめています。この先は反論・方法論・未解決の問いまで踏み込みます。
結局、「誤りの割合」はどの分野の、どんな研究を対象にするかで大きく変わります。ランダム化比較試験の多い一流医学誌の論文と、探索的な小規模研究とでは、同じ数字になるはずがありません。
06研究史の中の位置づけ
ヨアニディスさんの論文自体は、新しい統計手法を発明したものではありません。検査の陽性的中率の考え方は昔からありました。
この論文の功績は、それを「発表された研究全体」にあてはめ、研究の規模・分析の柔軟性・利害・競争といった、科学の“生態系”の性質と結びつけたことにあります。
その後の10年あまりで、検出力の重視、事前登録、データ公開、大規模な追試プロジェクトといった改革が次々と進みました。「メタサイエンス(科学についての科学)」と呼ばれる分野の、出発点の一つといえる論文です。
07まとめ
「発表された研究の大半はまちがい」。この言葉は、半分ホントで、半分は言いすぎです。
ホントなのは、「有意」という一つの判定だけでは、結果が正しいかどうかは決まらないということ。当たりの少ない分野で、小さな研究を、柔軟な分析で行えば、有意な結果の中にハズレが多く混ざるのは計算上避けられません。
言いすぎなのは、それがあらゆる研究に一律に当てはまるかのように聞こえること。答えは、分野と前提しだいです。
ニュースで「研究で判明!」を見たら、「その研究は大きかった? ほかでも確かめられた?」と問いかけてみてください。それだけで、ハズレを引く確率はぐっと下がります。
この研究を英語で読もう原田英語の English CornerJohn Ioannidis's 2005 essay has one of the boldest titles in science, "Why Most Published Research Findings… 音声
 4択クイズ9問A2・B1・B2タップして開く
原田英語の English Corner
この研究を英語で読もう
In 2005, a medical researcher named John Ioannidis wrote a famous paper. Its title said that most published research findings are false. He did not check old papers one by one. He used math.
In some fields, only a few ideas are true. If scientists run many small studies, some false ideas will pass the test by luck. Then many "discoveries" are wrong. Other experts said his answer depends on his guesses.
72 words ・ CEFR A2
和訳を見る
2005年、ジョン・ヨアニディスという医学研究者が、有名な論文を書きました。そのタイトルは「発表された研究結果の大半はまちがいだ」というものでした。彼は昔の論文を一つずつ調べたわけではありません。数学を使ったのです。
分野によっては、正しいアイデアがほんの少ししかありません。科学者が小さな研究をたくさん行うと、まちがったアイデアのいくつかが運よくテストに合格してしまいます。すると、たくさんの「発見」がまちがいになります。ほかの専門家たちは、彼の答えは彼の推測しだいだと言いました。
4択リーディングクイズ
Q1. What is the passage mainly about?
ヨアニディスさんが数学を使って「多くの発見はまちがい」と論じた論文の話なので A。
Q2. How did Ioannidis make his point?
He did not check old papers one by one. He used math. とあるので B。
Q3. In this passage, "by luck" means ...
by luck は「運よく、偶然に」。by chance と同じ意味なので B。
John Ioannidis's 2005 essay has one of the boldest titles in science, "Why Most Published Research Findings Are False." The paper does not count mistakes in real studies. It uses a probability model. Suppose 1,000 ideas are tested and only 100 are true.
With the usual 5 percent threshold, about 45 false ideas will look significant by chance. If studies are small and can detect a true effect only 20 percent of the time, just 20 true ideas will pass.
So most of the significant results would be false. Ioannidis listed conditions that make this worse, such as small studies, small effects, flexible analyses and financial interests. Critics answered that the result depends heavily on these starting assumptions.
118 words ・ CEFR B1
和訳を見る
ジョン・ヨアニディスさんの2005年の論文は、科学の世界で最も大胆なタイトルの一つ、「発表された研究結果の大半はなぜ誤りなのか」を持っている。この論文は、実際の研究のまちがいを数えたものではない。確率のモデルを使っている。1,000個のアイデアが調べられ、正しいのは100個だけだとしよう。
ふつうの5%の基準では、まちがったアイデアのうち約45個が偶然有意に見える。研究が小さく、本当の効果を見つけられるのが20%の確率しかなければ、合格する正しいアイデアは20個だけだ。
そうなると、有意な結果の大半はまちがいになる。ヨアニディスさんは、小さな研究、小さな効果、柔軟な分析、金銭的な利害など、状況を悪くする条件を挙げた。批判者たちは、その結果はこうした出発点の前提に大きく左右されると反論した。
4択リーディングクイズ
Q1. What kind of paper did Ioannidis write?
The paper does not count mistakes in real studies. It uses a probability model. とあるので B。
Q2. In the example, how many true ideas pass when studies can detect a true effect only 20 percent of the time?
just 20 true ideas will pass とあるので D。45 は偶然有意になるまちがったアイデアの数。
Q3. Why might critics object to the paper's conclusion?
Critics answered that the result depends heavily on these starting assumptions とあるので B。
A significant result is not the same as a true result, and John Ioannidis built a famous 2005 essay on that gap. His model treats research like a medical screening test. The share of significant findings that are real depends on how many tested ideas were true to begin with, how much statistical power the studies had, and how much bias crept into analysis and reporting.
For a large, well-run clinical trial of an idea with even odds of working, he estimated that a positive finding would be right about 85 percent of the time. For small exploratory studies, the figure fell far below half. The statisticians Steven Goodman and Sander Greenland objected that the model sorts every result into significant or not, ignoring how strong the evidence is, and that the low starting odds he assumed largely decide the outcome.
Leah Jager and Jeffrey Leek later collected 5,322 p-values from top medical journals and put the false discovery rate at about 14 percent. Ioannidis replied that their sample was highly selective. For psychology, a 2015 project that repeated 100 studies offered a rough check: only 36 percent of the repeats came out significant.
194 words ・ CEFR B2
和訳を見る
有意な結果は、正しい結果と同じではない。ジョン・ヨアニディスさんは、2005年の有名な論文をこのギャップの上に組み立てた。彼のモデルは、研究を医療のスクリーニング検査のように扱う。有意な結果のうち本物がどれだけあるかは、調べたアイデアのうちもともと正しいものがどれだけあったか、研究にどれだけの検出力があったか、そして分析や報告にどれだけのバイアスが入り込んだかによって決まる。
うまくいく見込みが五分五分のアイデアを、大規模でしっかりした臨床試験で調べた場合、陽性の結果が正しいのはおよそ85%だと彼は見積もった。小規模な探索的研究では、その数字は半分をはるかに下回った。統計学者のスティーヴン・グッドマンさんとサンダー・グリーンランドさんは、このモデルがすべての結果を有意か否かに振り分け、証拠の強さを無視していること、そして彼が仮定した低い出発点の見込みが結果をほぼ決めてしまっていることに異議を唱えた。
リア・ジェーガーさんとジェフリー・リークさんはその後、一流医学誌から5,322個の p 値を集め、偽の発見の割合を約14%と見積もった。ヨアニディスさんは、彼らのサンプルは強く選別されたものだと反論した。心理学については、2015年に100の研究をやり直したプロジェクトが大まかな手がかりを示した。追試で有意になったのは36%だけだったのだ。
4択リーディングクイズ
Q1. According to the passage, which factor does NOT affect the share of significant findings that are real?
本文で挙げられた3つの要因は、もともとの正しいアイデアの割合・検出力・バイアス。ページ数は出てこないので D。
Q2. What was Goodman and Greenland's criticism?
ignoring how strong the evidence is, and that the low starting odds he assumed largely decide the outcome とあるので A。
Q3. What can be inferred from the estimates in the passage?
大規模臨床試験では約85%が正しい一方で小規模研究では半分を大きく下回り、一流医学誌の推定は約14%など、対象によって数字が大きく変わるので B。
重要単語
- false positiveC1名詞(句)偽陽性A false positive can look just like a real discovery.
 検査で「陽性」と出たのに実際は陰性のこと。反対は false negative(偽陰性)。
- statistical powerC1名詞(句)検出力Small studies often have low statistical power. 本当の効果を見つけられる確率。power は「力」だけでなく統計では専門用語になる。
- probabilityB2名詞確率、見込みThe probability of a true finding depends on the field. 形容詞 probable(ありそうな)、副詞 probably(たぶん)と同じ語源。
- biasB2名詞偏り、偏見Bias can push weak results across the line. 統計では「系統的なずれ」、日常では「偏見」。be biased against ~ で「~に偏見を持つ」。
- assumptionB2名詞前提、仮定The conclusion depends on the assumptions. 動詞 assume(仮定する、思い込む)。make an assumption で「仮定を立てる」。
- replicationC1名詞追試、再現Replication tests whether a result holds up. replicate(再現する)の名詞形。reproducibility(再現性)とあわせて科学英語の頻出語。
- thresholdC1名詞しきい値、境目The usual threshold for significance is 5 percent. もとは「敷居」。on the threshold of ~ で「~の始まりに」。発音は THRESH-hold。
 入試に出る順の単語帳を印刷する →
 全5633語の「科学英単語カード」で復習する →
 動画でもっと知る
動画は各チャンネルの公式埋め込みで表示しています(YouTube)。
この話題を TED で聞く
同じテーマの TED・TED-Ed を、 TED HACK で。英語の見どころ・使える表現・学習ミッションつきの日本語ガイドです。(運営:原田英語)

 4コマでわかる
このネタ、誰かに教えたくなった?
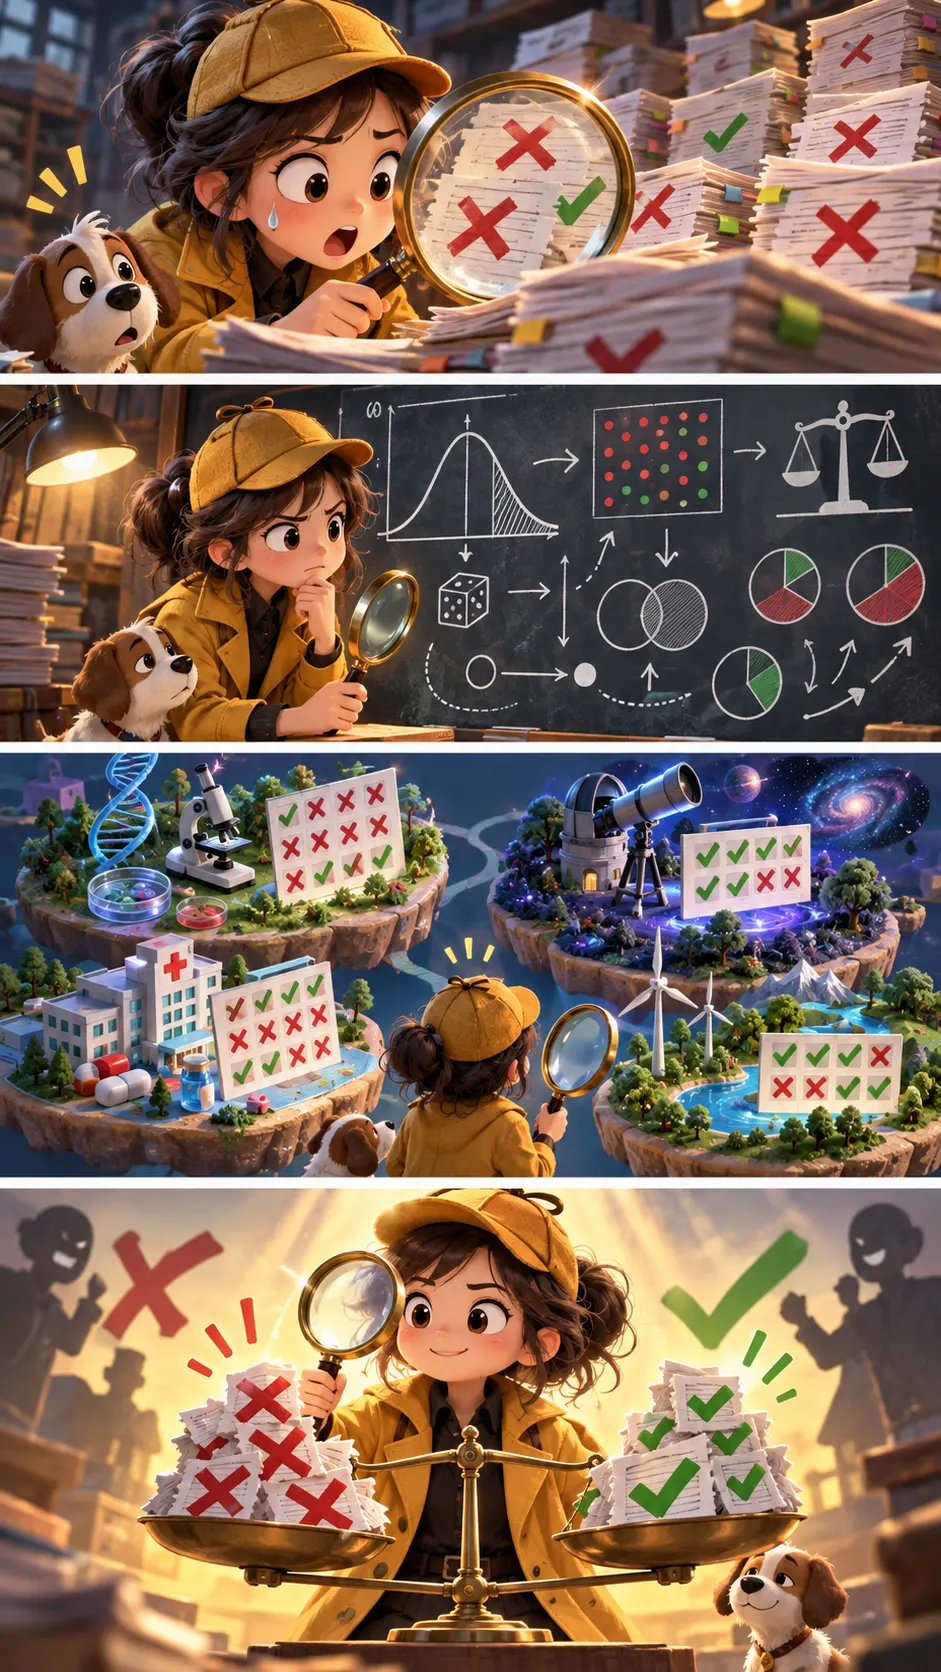
「発表された研究結果の大半はまちがい」という論文が2005年に出た。実はデータ集めではなく“確率の計算”の論文。当たりの少ない分野で小さな研究をたくさんやると、「有意」の中にハズレが増える。反論も含めて読み解く。
押すと「マジかリスト」に保存されます
 出典・参考文献(5件)タップで表示
 原典ガイド:入門から読むと入りやすく、必読は議論の土台、発展はその先の論点です。
- 必読Ioannidis (2005) Why Most Published Research Findings Are False, PLoS Medicinedoi.org議論の出発点。陽性的中率の式、誤りやすさの6条件、研究の種類ごとの試算
- 必読Goodman & Greenland (2007) Why Most Published Research Findings Are False: Problems in the Analysis, PLoS Medicinedoi.org同じ誌上での反論。結果を「有意かどうか」の二択で扱うモデルの問題点と、前提が結論を決めているという指摘
- 発展Jager & Leek (2014) An estimate of the science-wise false discovery rate and application to the top medical literature, Biostatisticsdoi.org一流医学誌の要旨に書かれた p 値から、偽の発見の割合を推定した研究。推定手法とその限界を考える材料に
- 入門Button et al. (2013) Power failure: why small sample size undermines the reliability of neuroscience, Nature Reviews Neurosciencedoi.org検出力不足が「見逃し」だけでなく、有意な結果の信頼性や効果の過大評価にもつながることを整理した総説
- 発展Open Science Collaboration (2015) Estimating the reproducibility of psychological science, Sciencedoi.org心理学100研究の大規模追試。再現率の数字を「正しい研究の割合」と読んでよいかを考える材料に
※本記事は上記の研究・公開資料をもとに、原田英語が独自の言葉で解説したものです。引用は著作権法第32条の範囲で行い、出典を明記しています。画像はすべてオリジナルのイメージです。研究結果には限界や個人差があります。誤りのご指摘は原田英語のお問い合わせフォームから。
 これも「マジか!?」
 心理学 ゼミ★★☆
同じデータを29チームに渡したら、答えがバラバラになった。「分析の自由度」という科学の盲点
 検証 ゼミ★★☆
「男性の合格率が高い=女性差別」は早とちり? バークレー大学院入試とシンプソンのパラドックス
 脳・心理 ゼミ★★☆
死んだサケの脳が「光った」。fMRIの統計の落とし穴を暴いた伝説の実験
 検証
「左利きは9年早死に」という研究があった。世界を騒がせた数字は"統計のワナ"だった
 検証
人差し指と薬指の長さで性格はわかる? 「2D:4D比」を大人数で確かめたら“ほぼ無関係”
 検証